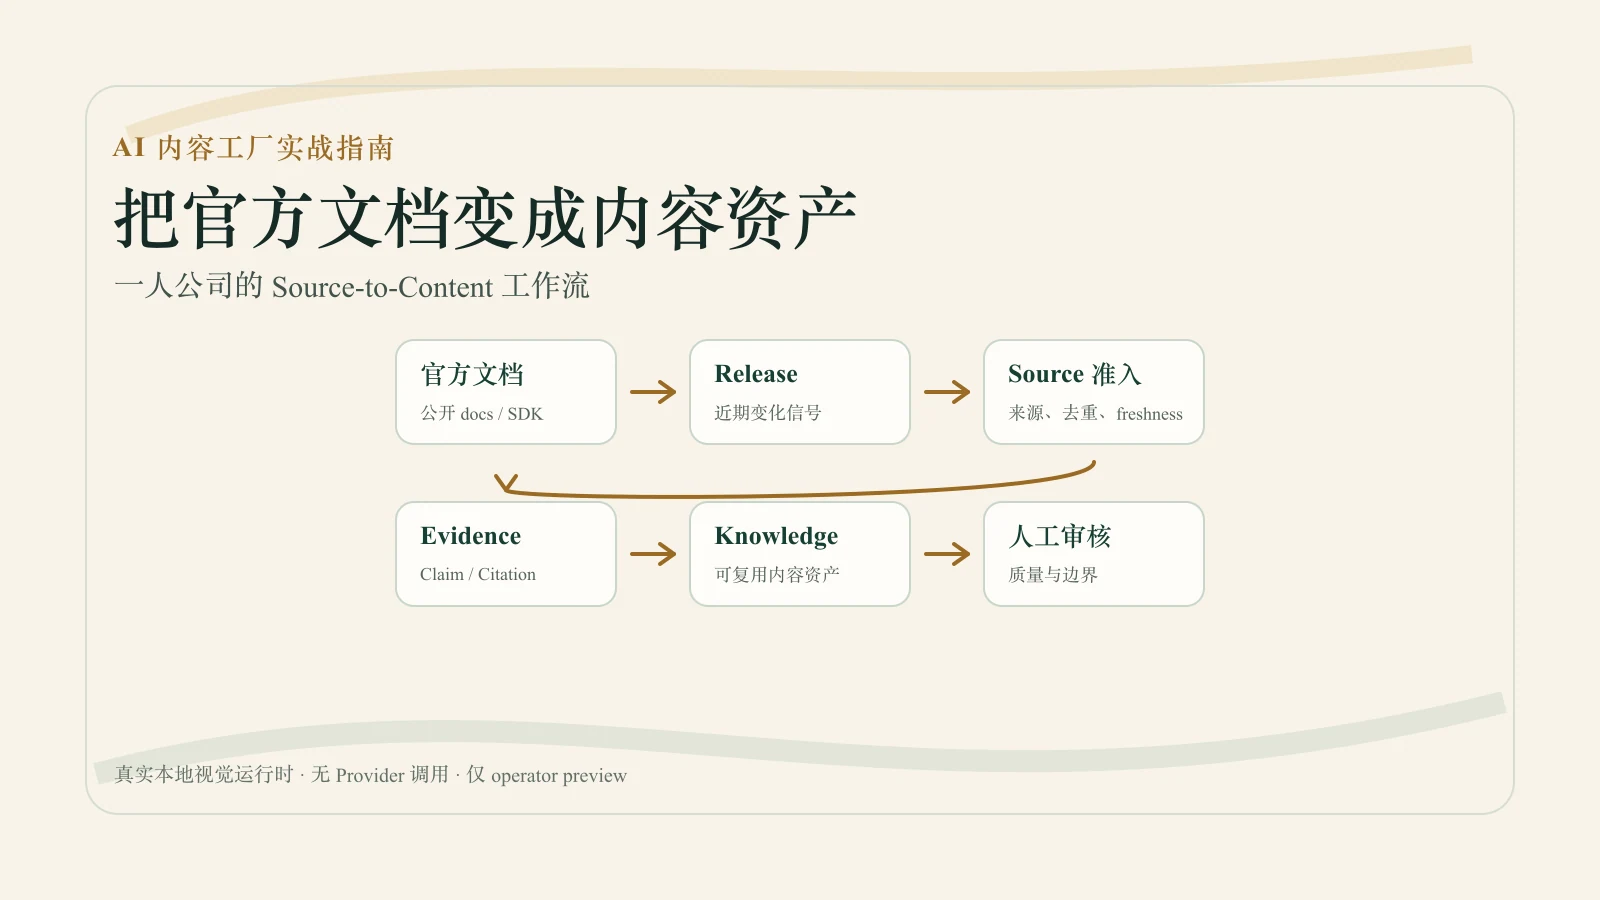
我做内容工厂时,最想减少的不是写作时间,而是选题的不确定性。对一人公司来说,官方文档、SDK 文档和 release 页面是更稳定的起点:它们公开、结构清楚、会持续更新,也更容易被拆成可核验的事实。读完这篇,你可以照着建立一条最小流程:先判断来源能不能进库,再把来源拆成声明、证据和引用,最后交给内容生产链复用。
本轮素材来自六个公开来源页面,覆盖 github.com、developers.openai.com、openai.github.io 和 ai-sdk.dev 四个域名。但它们只属于 OpenAI 与 Vercel / AI SDK 两个发布者家族,所以我不会把“四个域名”说成“四个完全独立发布者”。这个边界很重要:来源多样性可以提高复核面,但不能被写成外部市场证明。
1. 为什么先跟踪官方文档和 release 页面
release 页面给我变化信号,文档页面给我使用语境。OpenAI Agents SDK 的 release 记录里,本轮抓到 v0.17.3、v0.17.4、v0.17.5 等近期版本,发布时间集中在 2026 年 5 月到 6 月。这些信息本身不是文章结论,但可以提示我哪些主题值得进入候选池。文档页面再回答:这些变化在官方叙述里属于什么能力、什么流程、什么使用边界。
我更愿意从这类来源开始,不是因为它们一定“更会带来流量”,而是因为稳定来源能被反复检查,也能在后续生产前保留事实链路。
2. 先把五个术语说清楚
在这套流程里,来源文档(Source Document)指经过来源、时间和发布者身份登记的原始公开页面。声明(Claim)指准备在内容中表达、但必须先找到证据支持的具体判断。证据(Evidence)指原始来源中能够直接支持某条声明的内容片段。引用(Citation)指读者或审核者可以追溯到公开来源的出处信息。知识工件(Knowledge Artifact)指完成声明、证据、引用、限制和 freshness 整理后,可交给后续内容员工复用的结构化知识输入。
我以前最容易跳过的是这一步:看到一个文档更新,就直接写成观点。现在我会先问:这是来源、声明、证据,还是只是一个写作灵感?如果混在一起,后面再审核和复用都会含糊。
3. 来源准入小表
下面是公开页面上可以展示的简化表。它不暴露内部 source ID、证据包 ID 或本机路径,只保留读者能理解的来源信息。
| 来源页面 | 来源类型 | 发布者家族 | 抓取或访问时间 | freshness 状态 | 可支持的声明 | 是否需要复核 |
|---|---|---|---|---|---|---|
| OpenAI Agents Python v0.17.5 | GitHub release | OpenAI | 2026-06-23 | 2026-06-11 发布,60 天内 | 近期 release 变化信号 | 新版本发布时复核 |
| Agents SDK | OpenAI API | 官方开发者文档 | OpenAI | 2026-06-23 | 访问时有效 | 运行、编排、护栏、可观测与评估主题 | 文档结构变化时复核 |
| OpenAI Agents SDK | 官方 SDK 文档 | OpenAI | 2026-06-23 | 访问时有效 | agents、handoffs、guardrails、tracing、eval 语境 | SDK 文档改版时复核 |
| Getting Started: Coding Agents | AI SDK 文档 | Vercel / AI SDK | 2026-06-23 | 访问时有效 | Agent Skills、本地文档与 DevTools 可见性 | AI SDK 文档更新时复核 |
这张表的价值不是“看起来专业”,而是逼我在写作前记录来源时间、区分域名和发布者家族,并标出未来复核触发条件。
4. 一个端到端小案例
我用 OpenAI Agents Python v0.17.5 这条 release 作为例子。它先被登记为来源文档:页面来自 GitHub release,发布者家族是 OpenAI,发布时间是 2026-06-11,抓取时间是 2026-06-23,属于 60 天窗口内的近期来源。它能提供“近期变化信号”,但不能证明市场采用,也不能证明我的项目已经接入该 SDK。
接着我提取一条可写入文章的声明:官方 release 与文档页面可以共同支持一人公司持续跟踪 agent 工作流相关变化。证据不是一句泛泛判断,而是两类公开材料:release 页面提供近期版本发布时间,OpenAI 开发者文档把 Agents SDK 放在运行 agents、编排、护栏、集成与可观测、工作流评估等主题旁边呈现。公开引用只显示页面名称和 URL,例如 OpenAI Agents Python v0.17.5 与 Agents SDK | OpenAI API。
进入知识工件时,我会把这条记录写成更克制的输入:可写角度是“官方文档和 release 页面适合作为持续来源入口”;限制是“这不是市场采用率、收入、流量或生产效果证明”;复核触发是“OpenAI 发布新版本或文档结构变化时,重新检查版本相关声明和工作流能力描述”。最后它才能变成正文:持续跟踪 release 页面获得变化信号,再用官方文档确认能力语境,而不是把一条版本更新写成商业结论。
5. Evidence Pack 小样例
声明:官方 Agent SDK 文档将工作流、追踪和评估列为核心能力主题。
证据:OpenAI 开发者文档的 Agents SDK 页面列出运行 agents、编排、护栏、集成与可观测、评估 agent 工作流等主题;OpenAI Agents SDK 文档说明内置 tracing 可用于可视化、调试和评估 agentic flows。
限制:这是官方能力说明,只能支持“文档如何组织能力主题”这一类事实,不能证明市场采用率、收入、内容效果,也不能证明本项目已经完成 SDK 生产接入。
引用:Agents SDK | OpenAI API;OpenAI Agents SDK。
这就是我需要的证据包颗粒度:把声明、证据、限制和公开出处分开,让后续写作不会把来源解释成自己想要的结论。
6. 交给内容生产链
知识工件通过后,才会变成内容 brief。后续内容员工需要的不是一堆链接,而是明确的主题边界、可用声明、证据摘要、公开引用和禁止越界的说明。AI SDK 文档中提到 Agent Skills 的 progressive disclosure:启动时只暴露名称和描述,任务需要时再加载完整指令。这个原则也适合一人公司的内容系统:先让每个环节看见边界,再按需读取证据。
AI SDK 还说明本地安装后,文档与源码可在 node_modules 中读取,DevTools 可查看请求、响应和工具调用。这提醒我,内容链除了最终文章,还要留下本地可复查的知识、审计和运行边界。
7. 当前能力边界
这次验证的是从真实公开来源出发,完成来源准入、去重、freshness 判断、声明、证据与引用包、知识工件,再交给内容生成和质量链。没有验证外部 SDK 已接入本项目,没有验证通用 crawler 运行时,没有验证平台分发、线上增长、收入、客户或商业结果。文章只能讨论已完成的工作流步骤,不能把官方文档推导成外部市场证明。
8. 我会怎样复用
我的七步框架是:
- 选定官方文档、SDK 文档或 release 页面。
- 建立来源文档表,记录页面、发布者家族、访问时间和 freshness。
- 区分域名数量与发布者家族数量,避免把同一体系的多个页面当成多方证明。
- 从文档里抽取可被证据支持的声明。
- 给每条声明绑定证据摘要、限制和公开引用。
- 通过知识工件生成内容 brief,明确能写什么和不能写什么。
- 交给 Provider、引用审核、fuyuzhe、Socratic 和 Humanizer 逐步检查;来源变化时,先回到证据层重算,再决定是否复用旧知识。
最后我会用这张检查清单收尾:
- □ 来源是公开可访问的一手或可信页面
- □ 记录发布日期、更新时间和访问时间
- □ 区分域名数量与发布者家族数量
- □ 每条关键声明有对应证据
- □ 引用可以回到公开页面
- □ 记录事实限制和未知项
- □ 来源变化时重新检查相关声明
- □ 通过审核后再进入知识工件和内容生产
这样做不是让 AI “随便写”,而是让一人公司拥有一条可追溯、可复查的内容资产生产线。
Source transparency
这篇内容的来源边界
- 已承载:operator 接受的中文文章、来源证据链、质量审核记录与受控 Astro 页面。
- 公开策略:页面隐藏内部引用标记、仓库路径、runtime 路径和本机路径,只展示读者可理解的事实边界。
- 仍不声称:正式生产发布、外部市场证明、客户证明、收入证明、流量证明或多语言公开发布完成。
Citation policy
内部引用链已保留
本公开 noindex 试点隐藏内部 citation marker、内部证据 ID 和仓库路径。完整 traceability 保留在仓库的任务工件中,用于 operator 审核和后续质量链。